김정훈 연락하기

이즈파크 R&D Center · AI Researcher

김정훈

ML Engineer

AI 모델의 성능 개선부터 제품 적용까지 주도하는 ML Engineer입니다. 멀티모달 연구에서 쌓은 실험 역량을 바탕으로 TieMing의 주력 AI 기능을 개발하고 있습니다. 모델 학습부터 추론 API 구현과 서비스 배포까지 직접 맡아, 연구 아이디어를 실제 사용 가능한 기능으로 완성해 왔습니다.

김정훈 프로필 사진

학력한성대학교 컴퓨터공학부 · 공학사

연구논문 5편 · 제1저자 4편

GitHub / thuygom

프로젝트

회사 제품 · 관계 관리 AIAI SUMMIT SEOUL 2026 공개 시연

사람·회사·회의 정보를 잇는 AI 비서제품명 TieMing

TieMing의 주력 AI 기능을 맡아 명함 인식부터 회의 기록·영업 데이터 조회까지 개발했습니다. 명함을 다시 입력하고 기록을 따로 찾던 업무를 줄일 수 있도록, 사람·회사 정보를 중심으로 AI 기능을 통합했습니다.

웹 데모 열기 https://portfolio-tieming.jhkim3ispark.work
출시 준비 중

TieMing 애플리케이션의 주력 AI 기능 담당 · 명함 정보 추출 · 검색 · 음성 · CRM 조회
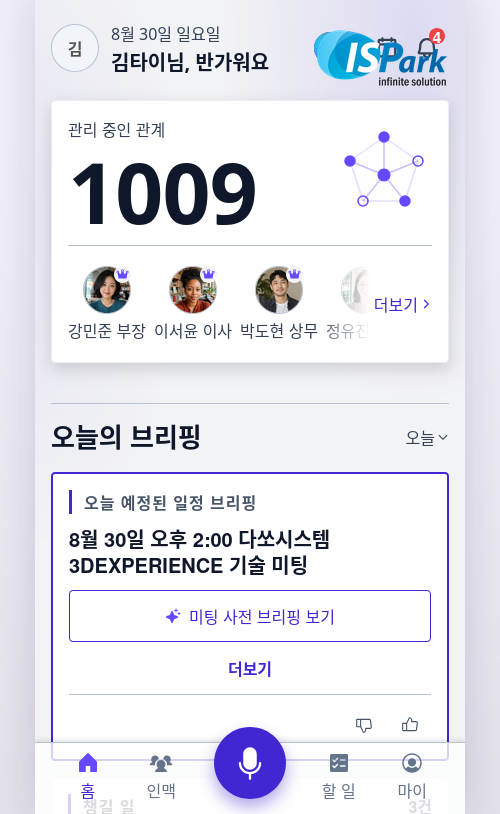
TieMing 데모의 인맥 관리와 오늘의 브리핑 화면
담당 업무TieMing 주력 AI 기능 담당
  • 명함 글자 인식·이름/회사/연락처 추출
  • 사람·기업 정보 검색
  • 회의 음성 실시간 전사
  • 영업 데이터 자연어 조회
  • 대화형 음성비서

공개 데모는 내부 운영 데이터와 분리된 포트폴리오용 인스턴스입니다.

회사 업무 · 영업 정보를 질문으로 조회

업무 질문을 정확한 데이터 조회로Text-to-SQL: 자연어를 데이터베이스 조회문으로 변환

영업 담당자가 자연어로 데이터를 조회하도록 검색·SQL 생성·실행 검증을 설계했습니다. 사내 약어와 테이블 관계를 보완해 필요한 자료를 좁히고, 모델 후학습으로 내부 평가의 결과 일치율을 26.6%에서 76.6%로 높였습니다.

영업 데이터 조회 데모 열기 https://portfolio-t2s.jhkim3ispark.work
예시 질문“이번 분기 영업 현황은?”
  1. 01질문에 필요한 자료 찾기약어와 테이블 관계 설명 보완
  2. 02조회 범위 확인허용된 자료와 조회량 검사
  3. 03읽기 전용 조회정상 결과·빈 결과·오류 구분

권한 조건이 빠져도 다른 사람의 데이터가 섞이지 않게

설계 과제

질문에 맞는 조회와 사용자별 정보 보호를 함께 보장해야 했습니다. 생성 SQL에서 권한 조건이 빠지는 경우까지 고려했습니다.

직접 설계

PostgreSQL Row Level Security(행 수준 보안)로 DB가 허용된 행만 반환하게 해, 모델 생성과 권한 검사를 분리했습니다.

검증 결과

격리 환경의 두 계정 비교에서 타인 행 노출 0건을 확인했습니다. 권한 회수·복원에 따른 조회 결과도 검증했습니다.

접근 정책 설계와 격리 환경 검증을 주도하고, 운영 담당자와 실제 시스템 연결을 진행했습니다.

모델 후학습으로 조회 결과 일치율 50%p 향상

기준 모델
26.6%
정답 결과 일치 17 / 64
후학습 모델
76.6%
정답 결과 일치 49 / 64
같은 평가에서의 개선
+50%p
내부 CRM 질문 64건

교사 모델의 응답으로 학습 자료를 구성하고 학생 모델에 LoRA 후학습을 적용했습니다. 내부 CRM 64문항에서 행 순서를 제외하고 숫자·날짜를 정규화한 실행 결과를 비교했습니다. 공개 데모는 별도로 구성했습니다.

특허 ↗
특허 출원 · 심사청구 중데이터베이스 설명 자동 생성 및 환각 억제 전처리 방법
실시간 전사 · 회의록

업무 용어를 반영한 회의 전사·화자 분리서비스명 iScribe

음성 인식·화자 분리 모델을 비교해 TieMing의 회의 기록 기능에 적용했습니다. 영업·제조 용어사전과 Honcho 기반 사용자별 기억으로 개인 단어와 맥락을 반영했습니다. 실시간·장시간 처리를 분리하고 중단된 작업의 복구까지 설계했습니다.

iScribe 체험하기 https://iscribe.jhkim3ispark.work

음성 처리 과정

  1. 말소리 구간 찾기
  2. 음성을 글로 변환
  3. 화자 분리
  4. 회의록
실시간 대화 종료 · 재연결 · 시간 초과장시간 작업 단계 저장 · 동시 작업 방지 · 재시작 복구

한국어 회의 품질과 처리 속도를 함께 개선

단어 오류율 (WER)
약 19%
내부 한국어 업무 회의
화자 구분 오류율 (DER)
약 23%
내부 한국어 업무 회의
서버 처리시간 단축
36.9%
30분 음성 1건 · 122.6 → 77.4초

품질은 내부 한국어 회의 기준입니다. 처리시간은 말소리 구간 감지(VAD)와 배치 추론을 적용한 별도 30분 파일 비교입니다. 고난도 공개 음성 10건에서는 클로바노트·리멤버노트와 같은 조건으로 비교 평가했습니다.

세션 종료와 재처리 구현

사전학습 음성 인식·화자 분리 모델을 비교·통합하고, 모델 품질과 세션 안정성을 함께 개선했습니다. 늦게 도착한 음성·중복 종료·재연결을 처리하고, 서버 처리 완료 전 요청이 만료되던 긴 작업은 비동기로 분리했습니다.

사용 기술: FastAPI · PostgreSQL 작업 기록 · 사용자 로그인

명함 인식 · 모델 후학습 · 제품 적용
내 명함으로 정보 추출 체험 김정훈의 실제 이즈파크 명함
{

"이름": "김정훈",
"직함": "연구원",
"회사": "(주)이즈파크"

}

명함을 고객 정보로 바꾸는 AI

명함의 이름·회사·연락처를 앱에서 바로 쓰는 고객 정보로 구조화했습니다. 교사·학생 모델의 지식 증류와 LoRA 후학습으로 추출 모델을 개선하고, 항목 값과 출력 형식을 따로 교정해 실제 업무 적용까지 맡았습니다.

명함 정보 추출 데모 열기 https://portfolio-gomocr.jhkim3ispark.work

실제 업무 OCR · 핵심 7개 항목 정확도 94%

약 5,000장 적용 · 별도 후학습 평가는 구분해 측정
실제 업무 적용
94%
핵심 7개 항목 · 약 5,000장 규모
별도 후학습 평가
30.2 → 65.3%
항목 값 정확도

교사 모델의 지식을 학생 모델에 전달하는 지식 증류(Knowledge Distillation, KD)와 LoRA 후학습을 직접 적용했습니다. 문자 인식(OCR)과 핵심 정보 추출(Key Information Extraction, KIE)을 나눠 평가해 값 오류를 개선하고, 형식이 깨진 결과만 재생성했습니다. 30.2→65.3%는 후학습과 출력 보정을 함께 적용한 별도 평가입니다.

학습과 오류 분석 기록

글자 위치를 찾는 이미지 인식부는 유지하고, 이름·회사·연락처로 구조화하는 부분을 후학습했습니다. 실패한 결과를 분석하자 출력 형식 오류는 모델 전체를 더 학습하기보다 해당 결과만 다시 생성하는 편이 적절했습니다.

조정용 자료에서 학습·출력 조건을 선택하고 고정 평가 세트로 검증했습니다. 항목별 변화도 함께 추적해, 추가 보완이 필요한 주소 추출을 다음 개선 대상으로 정했습니다.

업무 기록 · 팀 위키

AI 코딩 기록을 검색·팀 위키로 연결

개인에게 흩어진 AI 코딩 기록을 팀이 재사용하는 검색·위키 기능을 개발했습니다. 사용자가 선택한 기록의 출처를 보존하고, 조직·부서·개인 권한에 따라 이전 작업과 판단 근거를 찾도록 설계했습니다.

사용자가 선택한 AI 작업 기록변경 기록 수집 출처 보존 · 검색팀 위키 출처 · 가시성 정책
작업 기록 검색 데모 열기 https://portfolio-isparkhub.jhkim3ispark.work
배포 · 모니터링

모델 배포부터 GPU 운영까지 직접 구성

추론 API의 배포와 모니터링을 맡아, 서비스 오류와 GPU 자원 경합을 구분할 수 있는 운영 환경을 구축했습니다. 요청·컨테이너 상태와 GPU 메모리·온도·전력을 함께 계측해 장애 원인을 추적하도록 했습니다.

서비스·GPU 상태 대시보드 보기 https://portfolio-observability.jhkim3ispark.work

문제 위치를 확인하는 흐름

AI 서비스상태 · 요청NVIDIA GPU메모리 · 온도 · 전력
상태·사용량 기록대시보드에서 확인

Linux 서버 · Docker 실행 환경 · Cloudflare Tunnel 접속

경력·학력

이즈파크 R&D Center

AI Researcher · TieMing 주력 AI 기능 개발

일학습병행 인턴 → 2026.03 정규직 전환

한성대학교 IRIS Lab

학부연구원 · 여러 입력을 결합하는 AI / 자연어 처리

논문 5편 · 제1저자 4편

한성대학교

컴퓨터공학부 · 공학사

GPA 3.95 / 4.5

공군 정보체계

병 21개월 · 전문하사 12개월

Linux 서버·정보체계 관리

사용 기술

Python·PyTorch(모델 학습) · FastAPI(서버 API) · PostgreSQL(데이터베이스) · Docker(실행·배포)

연구·기록

경로 최적화2025
IJIBC 17(3), 144–154 · KCI · 제1저자

음성·영상·문장 조합마다 계산량이 커지는 문제를 줄이도록, 입력에 따라 정보 결합 경로를 선택하는 방법을 연구했습니다.

Multimodal Routing Optimization via Neural Architecture Search of Fusion Paths

정책 학습2025
KSC 2025 · 제1저자 · 장려상

고정된 결합 방식의 한계를 줄이기 위해, 입력에 맞춰 모달 간 정보 경로를 학습하는 후속 연구입니다.

암시적 NAS 정책학습 기반
멀티모달 경로 최적화

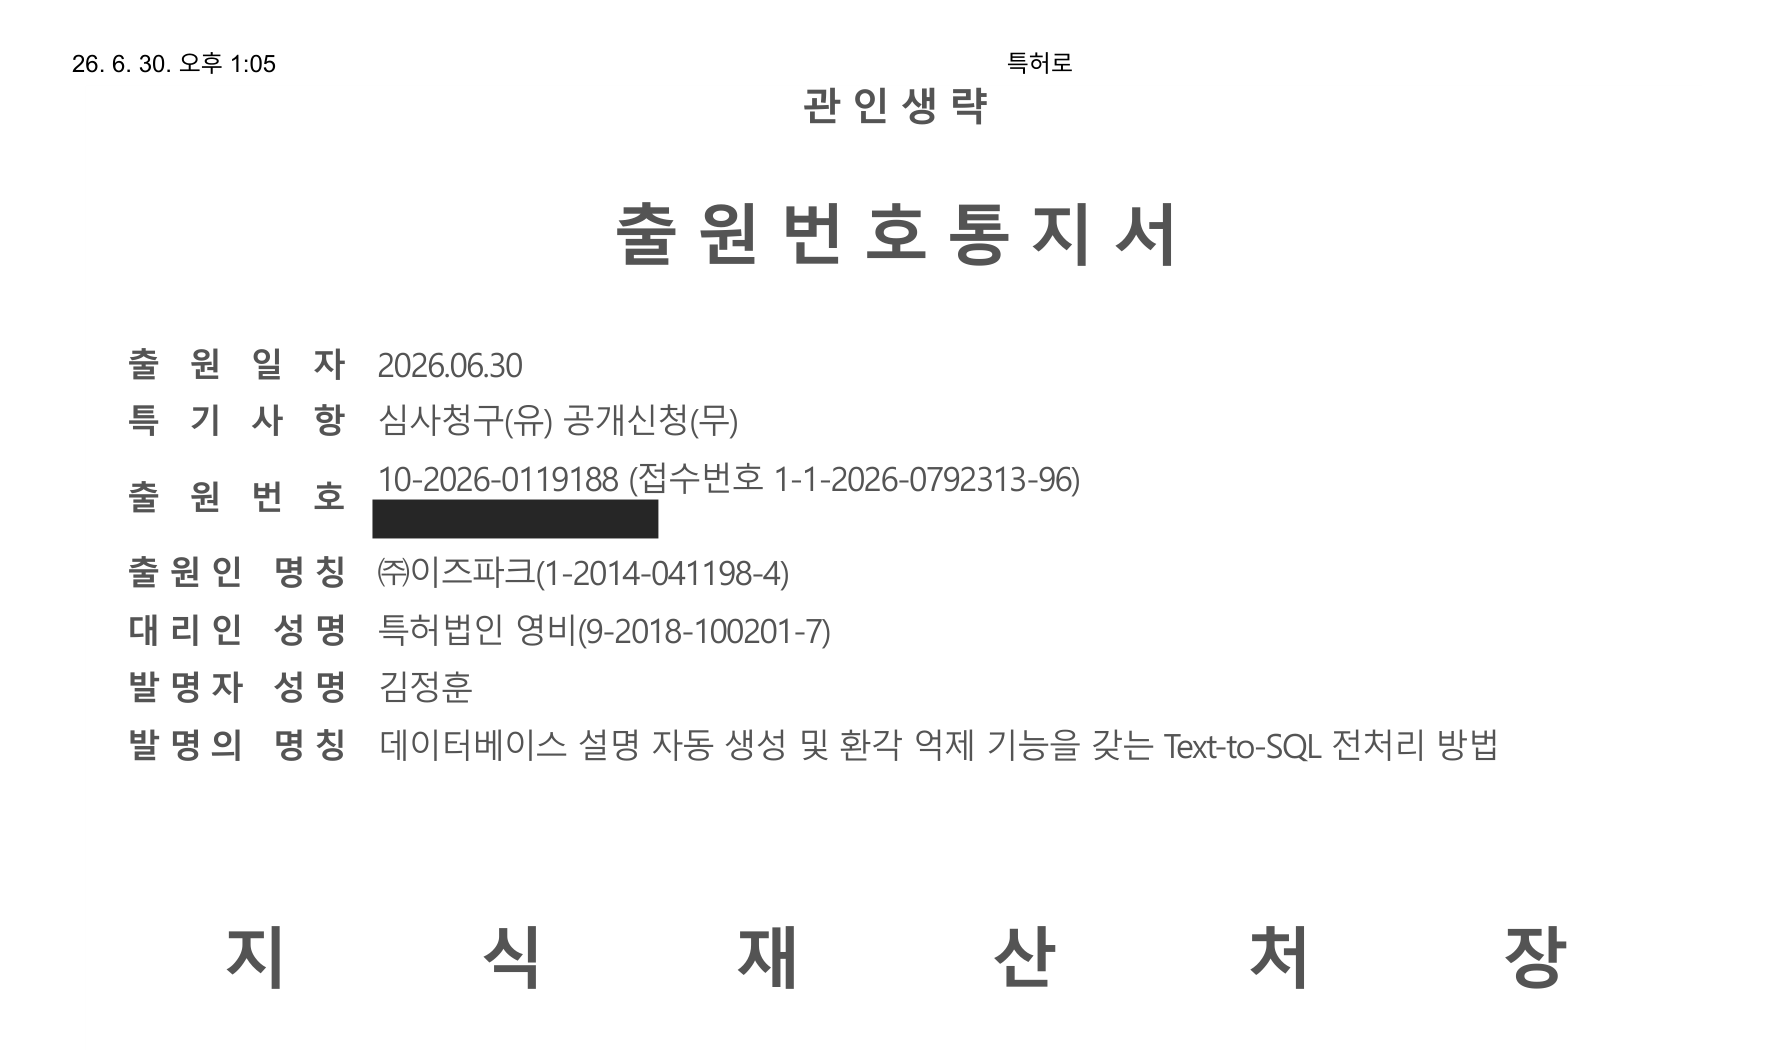
특허 · 출원 · 심사청구 중 · 2026 데이터베이스 설명 자동 생성 및 환각 억제 기능을 갖는 Text-to-SQL 전처리 방법

10-2026-0119188
2026.06.30 · 발명자 김정훈

2026년 6월 30일 접수된 특허 출원번호통지서. 출원번호 10-2026-0119188, 발명자 김정훈, 심사청구 유.
출원번호통지서

수상

  • 2026
    AI 스마트워크톤 경진대회은상

자격

  1. SW개발 L5국가자격 · 2026
  2. 정보처리산업기사2022
  3. 리눅스마스터 2급2022

수상 항목의 화살표를 누르면 증빙 이미지를 볼 수 있습니다.

수상 증빙